Domain halbleiterbauelement.de kaufen?
Wir ziehen mit dem Projekt
halbleiterbauelement.de um.
Sind Sie am Kauf der Domain
halbleiterbauelement.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain halbleiterbauelement.de kaufen?
Kann man Fachbücher von der Steuer absetzen?
Kann man Fachbücher von der Steuer absetzen? Ja, unter bestimmten Bedingungen können Fachbücher als Werbungskosten oder Betriebsausgaben steuerlich geltend gemacht werden. Voraussetzung ist, dass die Bücher beruflich genutzt werden und einen direkten Bezug zur ausgeübten Tätigkeit haben. Es ist wichtig, die entsprechenden Belege aufzubewahren und die Ausgaben in der Steuererklärung anzugeben. Es empfiehlt sich, im Zweifelsfall einen Steuerberater oder das Finanzamt zu konsultieren, um sicherzustellen, dass die Absetzbarkeit der Fachbücher korrekt erfolgt. **
Wie können Fachbücher zur Vertiefung von Fachwissen genutzt werden?
Fachbücher können genutzt werden, um spezifische Themen detaillierter zu verstehen und zu vertiefen. Sie bieten fundierte Informationen, Analysen und Fallstudien, die das Fachwissen erweitern können. Durch das Lesen von Fachbüchern können Experten ihr Wissen aktualisieren und neue Perspektiven gewinnen. **

Ähnliche Suchbegriffe für Reinforcement-Learning-Fachbücher-von
Top-Angebote
Produkte zum Begriff Reinforcement-Learning-Fachbücher-von:
-
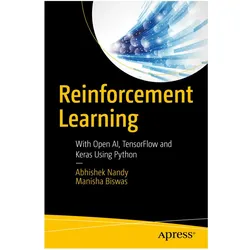
Reinforcement Learning, Fachbücher von Manisha Biswas, Abhishek NandyMeistern Sie das Verstärkungslernen, ein beliebtes Gebiet des maschinellen Lernens, beginnend mit den Grundlagen. Entdecken Sie, wie Agenten und die Umgebung sich entwickeln und gewinnen Sie ein klares Bild von ihrer Wechselbeziehung. Anschliessend arbeiten Sie mit Theorien, die mit dem Verstärkungslernen verbunden sind, und erkunden die Konzepte, die den Prozess des Verstärkungslernens aufbauen. Das Buch behandelt wichtige Algorithmusimplementierungen für das Verstärkungslernen, einschliesslich des Markov-Entscheidungsprozesses und des semi-Markov-Entscheidungsprozesses. Der nächste Abschnitt zeigt Ihnen, wie Sie mit OpenAI beginnen, bevor Sie sich mit OpenAI Gym beschäftigen. Danach lernen Sie über Schwarmintelligenz mit Python im Hinblick auf das Verstärkungslernen. Der letzte Teil des Buches beginnt mit der TensorFlow-Umgebung und skizziert, wie Verstärkungslernen auf TensorFlow angewendet werden kann. Es wird auch Keras behandelt, ein Framework, das mit Verstärkungslernen verwendet werden kann.69,54 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Sutton, Richard S.: Reinforcement LearningReinforcement Learning , An Introduction , > , Auflage: 2. Auflage, Erscheinungsjahr: 20181113, Produktform: Leinen, Titel der Reihe: Adaptive Computation and Machine Learning series##, Autoren: Sutton, Richard S.~Barto, Andrew G., Redaktion: Bach, Francis, Auflage: 18002, Auflage/Ausgabe: 2. Auflage, Abbildungen: 64 color illus., 51 b 115 Illustrations, unspecified, Themenüberschrift: COMPUTERS / Intelligence (AI) & Semantics, Keyword: technology;computer science;ai;computers;artificial intelligence;computer;algorithm;machine learning;algorithms;tech;superintelligence;intelligence;computer books;ai books;sci-fi;philosophy;mystery;psychology;business;thriller;meditation;sports;crime;cyberpunk;mindfulness;art;dystopia;suspense;health;anxiety;brain;sociology;internet;biography;self improvement;future;self help;neuroscience;classic;writing;cookbooks;career;essays;consciousness;gaming;communication;language;spirituality;cooking, Fachschema: Englische Bücher / Naturwissenschaften~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI~Algorithmus~Fuzzy Logik - Fuzzy Set~Neuronales Netz - Neuronaler Computer - Neurocomputer, Fachkategorie: Algorithmen und Datenstrukturen, Warengruppe: HC/Informatik, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 236, Breite: 184, Höhe: 40, Gewicht: 1192, Produktform: Gebunden, Genre: Importe,102,09 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Einstieg in Deep Reinforcement Learning, Fachbücher von Brandon Brown- Grundlegende Konzepte und Terminologie - Praktischer Einsatz mit PyTorch - Projekte umsetzen Dieses Buch zeigt Ihnen, wie Sie Agenten programmieren, die basierend auf direktem Feedback aus ihrer Umgebung selbstständig lernen und sich dabei verbessern. Sie werden Netzwerke mit dem beliebten PyTorch-Deep-Learning-Framework aufbauen, um bestärkende Lernalgorithmen zu erforschen. Diese reichen von Deep-Q-Networks über Methoden zur Gradientenmethode bis hin zu evolutionären Algorithmen. Im weiteren Verlauf des Buches wenden Sie Ihre Kenntnisse in praktischen Projekten wie der Steuerung simulierter Roboter, der Automatisierung von Börsengeschäften oder dem Aufbau eines Spiel-Bots an. Aus dem Inhalt: - Strukturierungsprobleme als Markov-Entscheidungsprozesse - Beliebte Algorithmen wie Deep Q-Networks, Policy Gradient-Methode und Evolutionäre Algorithmen und die Intuitionen, die sie antreiben - Anwendung von Verstärkungslernalgorithmen auf reale Probleme EXTRA: E-Book inside Systemvoraussetzungen für E-Book inside: Internet-Verbindung und Adobe-Reader oder Ebook-Reader bzw. Adobe Digital Editions.39,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Reinforcement Learning: An Introduction, Fachbücher von Richard S. Sutton, Andrew G. BartoDie erheblich erweiterte und aktualisierte Neuauflage eines weit verbreiteten Textes über Reinforcement Learning, einem der aktivsten Forschungsgebiete der künstlichen Intelligenz. Reinforcement Learning ist ein rechnergestützter Ansatz zum Lernen, bei dem ein Agent versucht, die Gesamtmenge der Belohnung zu maximieren, die er beim Interagieren mit einer komplexen, unsicheren Umgebung erhält. In "Reinforcement Learning" bieten Richard Sutton und Andrew Barto eine klare und einfache Darstellung der zentralen Ideen und Algorithmen des Fachgebiets. Diese zweite Auflage wurde erheblich erweitert und aktualisiert, wobei neue Themen behandelt und andere Themen aktualisiert wurden. Wie die erste Auflage konzentriert sich auch diese zweite Auflage auf die grundlegenden Online-Lernalgorithmen, wobei das mathematische Material in schattierten Kästen hervorgehoben wird. Teil I behandelt so viel wie möglich über Reinforcement Learning, ohne über den tabellarischen Fall hinauszugehen, für den exakte Lösungen gefunden werden können. Viele in diesem Teil vorgestellten Algorithmen sind neu in der zweiten Auflage, darunter UCB, Expected Sarsa und Double Learning. Teil II erweitert diese Ideen auf die Funktionsapproximation, mit neuen Abschnitten zu Themen wie künstlichen neuronalen Netzwerken und der Fourier-Basis, und bietet eine erweiterte Behandlung des Off-Policy-Lernens und der Policy-Gradient-Methoden. Teil III enthält neue Kapitel über die Beziehungen von Reinforcement Learning zur Psychologie und Neurowissenschaft sowie ein aktualisiertes Kapitel über Fallstudien, das AlphaGo und AlphaGo Zero, das Spielen von Atari-Spielen und die Wettstrategie von IBM Watson umfasst. Das letzte Kapitel diskutiert die zukünftigen gesellschaftlichen Auswirkungen des Reinforcement Learning.102,30 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann man die Effektivität von Reinforcement-Techniken in der Verhaltensänderung evaluieren? Welche Rolle spielen positive und negative Verstärkung dabei?
Die Effektivität von Reinforcement-Techniken kann durch die Messung von Verhaltensänderungen vor und nach der Anwendung der Techniken bewertet werden. Positive Verstärkung belohnt gewünschtes Verhalten, während negative Verstärkung unerwünschtes Verhalten durch das Entfernen von etwas Unangenehmem reduziert. Beide spielen eine wichtige Rolle bei der Verhaltensänderung, indem sie das gewünschte Verhalten verstärken und das unerwünschte Verhalten verringern. **
-
Wie funktioniert die Verwendung einer Diode zur Umwandlung von Wechselspannung?
Eine Diode kann verwendet werden, um Wechselspannung in Gleichspannung umzuwandeln, indem sie den Stromfluss in nur eine Richtung ermöglicht. Wenn die positive Halbwelle der Wechselspannung an die Diode angelegt wird, leitet sie den Strom und ermöglicht so den Durchfluss der positiven Halbwelle. Die negative Halbwelle wird jedoch blockiert, da die Diode in Sperrrichtung geschaltet ist. Dadurch wird die Wechselspannung in eine pulsierende Gleichspannung umgewandelt. **
-
Was ist eine Z-Diode mit einer Spannung von 5 Volt?
Eine Z-Diode ist eine spezielle Art von Diode, die für ihre Zener-Spannung bekannt ist. Eine Z-Diode mit einer Spannung von 5 Volt bedeutet, dass sie bei einer bestimmten Spannung in Durchlassrichtung zu leiten beginnt und diese Spannung bei 5 Volt liegt. Sie wird häufig in Schaltungen verwendet, um eine konstante Spannung zu erzeugen oder um Spannungsspitzen zu begrenzen. **
-
Was ist eine Z-Diode mit einer Spannung von 3 Volt?
Eine Z-Diode mit einer Spannung von 3 Volt ist eine spezielle Art von Diode, die als Spannungsregler verwendet wird. Sie hat die Eigenschaft, dass sie bei einer bestimmten Durchbruchspannung in Durchlassrichtung arbeitet und die Spannung auf diesem Wert begrenzt. Dadurch kann sie dazu verwendet werden, eine konstante Spannung von 3 Volt zu erzeugen, unabhängig von Schwankungen in der Eingangsspannung. **

Wie lautet die Reihenschaltung von Widerstand und Spule?
Die Reihenschaltung von Widerstand und Spule ergibt eine Impedanz, die den Gesamtwiderstand des Schaltkreises bestimmt. Der Widerstand und die Spule beeinflussen sich gegenseitig, wodurch der Stromfluss und die Spannung über den Bauteilen beeinflusst werden. In einer Reihenschaltung ist der Gesamtwiderstand gleich der Summe des Widerstands und der Spulenimpedanz. **
Von was ist der Widerstand einer Spule abhängig?
Der Widerstand einer Spule ist von verschiedenen Faktoren abhängig. Dazu gehören die Länge und der Querschnitt des Drahtes, aus dem die Spule besteht, sowie das Material des Drahtes. Außerdem spielt die Anzahl der Windungen und der Durchmesser der Spule eine Rolle. **
Top-Angebote
Produkte zum Begriff Reinforcement-Learning-Fachbücher-von:
-
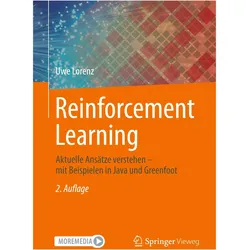
Reinforcement Learning, Fachbücher von Uwe LorenzIn uralten Spielen wie Schach oder Go können sich die brillantesten Spieler verbessern, indem sie die von einer Maschine produzierten Strategien studieren. Robotische Systeme üben ihre Bewegungen selbst. In Arcade Games erreichen lernfähige Agenten innerhalb weniger Stunden übermenschliches Niveau. Wie funktionieren diese spektakulären Algorithmen des bestärkenden Lernens? Mit gut verständlichen Erklärungen und übersichtlichen Beispielen in Java und Greenfoot können Sie sich die Prinzipien des bestärkenden Lernens aneignen und in eigenen intelligenten Agenten anwenden. Greenfoot und das Hamster-Modell sind einfache, aber auch mächtige didaktische Werkzeuge, die entwickelt wurden, um Grundkonzepte der Programmierung zu vermitteln. Wir werden Figuren wie den Java-Hamster zu lernfähigen Agenten machen, die eigenständig ihre Umgebung erkunden. Die zweite Auflage enthält neue Themen wie genetische Algorithmen und künstliche Neugier sowie Erklärungen zu aktuellen Algorithmen wie A3C und PPO, ausserdem Korrekturen und Überarbeitungen.34,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Reinforcement Learning, Fachbücher von Phil WinderDas Fachbuch "Reinforcement Learning: Industrial Applications of Intelligent Agents" von Phil Winder bietet eine umfassende Einführung in die Konzepte und Anwendungen des Reinforcement Learning im industriellen Kontext. Verfasst in englischer Sprache, richtet sich das Buch an Fachleute und Studierende im Bereich Technik und IT, die ein vertieftes Verständnis für intelligente Agenten und deren Einsatzmöglichkeiten in der Informatik erlangen möchten. Mit 381 Seiten behandelt das Werk sowohl theoretische Grundlagen als auch praktische Anwendungen, wodurch es sich als wertvolle Ressource für alle eignet, die sich mit modernen Technologien und deren Implementierung in der Industrie auseinandersetzen. Das Buch hat eine Breite von 18,3 cm und eine Höhe von 23,3 cm, was es handlich und leicht zugänglich macht. Mit einem Gewicht von 710 Gramm ist es zudem gut transportierbar. Die Publikation aus dem Jahr 2020 ist ein unverzichtbares Nachschlagewerk für alle, die sich mit den Herausforderungen und Chancen des Reinforcement Learning beschäftigen.53,70 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Reinforcement Learning, Fachbücher von Manisha Biswas, Abhishek NandyMeistern Sie das Verstärkungslernen, ein beliebtes Gebiet des maschinellen Lernens, beginnend mit den Grundlagen. Entdecken Sie, wie Agenten und die Umgebung sich entwickeln und gewinnen Sie ein klares Bild von ihrer Wechselbeziehung. Anschliessend arbeiten Sie mit Theorien, die mit dem Verstärkungslernen verbunden sind, und erkunden die Konzepte, die den Prozess des Verstärkungslernens aufbauen. Das Buch behandelt wichtige Algorithmusimplementierungen für das Verstärkungslernen, einschliesslich des Markov-Entscheidungsprozesses und des semi-Markov-Entscheidungsprozesses. Der nächste Abschnitt zeigt Ihnen, wie Sie mit OpenAI beginnen, bevor Sie sich mit OpenAI Gym beschäftigen. Danach lernen Sie über Schwarmintelligenz mit Python im Hinblick auf das Verstärkungslernen. Der letzte Teil des Buches beginnt mit der TensorFlow-Umgebung und skizziert, wie Verstärkungslernen auf TensorFlow angewendet werden kann. Es wird auch Keras behandelt, ein Framework, das mit Verstärkungslernen verwendet werden kann.69,54 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Sutton, Richard S.: Reinforcement LearningReinforcement Learning , An Introduction , > , Auflage: 2. Auflage, Erscheinungsjahr: 20181113, Produktform: Leinen, Titel der Reihe: Adaptive Computation and Machine Learning series##, Autoren: Sutton, Richard S.~Barto, Andrew G., Redaktion: Bach, Francis, Auflage: 18002, Auflage/Ausgabe: 2. Auflage, Abbildungen: 64 color illus., 51 b 115 Illustrations, unspecified, Themenüberschrift: COMPUTERS / Intelligence (AI) & Semantics, Keyword: technology;computer science;ai;computers;artificial intelligence;computer;algorithm;machine learning;algorithms;tech;superintelligence;intelligence;computer books;ai books;sci-fi;philosophy;mystery;psychology;business;thriller;meditation;sports;crime;cyberpunk;mindfulness;art;dystopia;suspense;health;anxiety;brain;sociology;internet;biography;self improvement;future;self help;neuroscience;classic;writing;cookbooks;career;essays;consciousness;gaming;communication;language;spirituality;cooking, Fachschema: Englische Bücher / Naturwissenschaften~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI~Algorithmus~Fuzzy Logik - Fuzzy Set~Neuronales Netz - Neuronaler Computer - Neurocomputer, Fachkategorie: Algorithmen und Datenstrukturen, Warengruppe: HC/Informatik, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 236, Breite: 184, Höhe: 40, Gewicht: 1192, Produktform: Gebunden, Genre: Importe,102,09 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kann man Fachbücher von der Steuer absetzen?
Kann man Fachbücher von der Steuer absetzen? Ja, unter bestimmten Bedingungen können Fachbücher als Werbungskosten oder Betriebsausgaben steuerlich geltend gemacht werden. Voraussetzung ist, dass die Bücher beruflich genutzt werden und einen direkten Bezug zur ausgeübten Tätigkeit haben. Es ist wichtig, die entsprechenden Belege aufzubewahren und die Ausgaben in der Steuererklärung anzugeben. Es empfiehlt sich, im Zweifelsfall einen Steuerberater oder das Finanzamt zu konsultieren, um sicherzustellen, dass die Absetzbarkeit der Fachbücher korrekt erfolgt. **
-
Wie können Fachbücher zur Vertiefung von Fachwissen genutzt werden?
Fachbücher können genutzt werden, um spezifische Themen detaillierter zu verstehen und zu vertiefen. Sie bieten fundierte Informationen, Analysen und Fallstudien, die das Fachwissen erweitern können. Durch das Lesen von Fachbüchern können Experten ihr Wissen aktualisieren und neue Perspektiven gewinnen. **
-
Wie kann man die Effektivität von Reinforcement-Techniken in der Verhaltensänderung evaluieren? Welche Rolle spielen positive und negative Verstärkung dabei?
Die Effektivität von Reinforcement-Techniken kann durch die Messung von Verhaltensänderungen vor und nach der Anwendung der Techniken bewertet werden. Positive Verstärkung belohnt gewünschtes Verhalten, während negative Verstärkung unerwünschtes Verhalten durch das Entfernen von etwas Unangenehmem reduziert. Beide spielen eine wichtige Rolle bei der Verhaltensänderung, indem sie das gewünschte Verhalten verstärken und das unerwünschte Verhalten verringern. **
-
Wie funktioniert die Verwendung einer Diode zur Umwandlung von Wechselspannung?
Eine Diode kann verwendet werden, um Wechselspannung in Gleichspannung umzuwandeln, indem sie den Stromfluss in nur eine Richtung ermöglicht. Wenn die positive Halbwelle der Wechselspannung an die Diode angelegt wird, leitet sie den Strom und ermöglicht so den Durchfluss der positiven Halbwelle. Die negative Halbwelle wird jedoch blockiert, da die Diode in Sperrrichtung geschaltet ist. Dadurch wird die Wechselspannung in eine pulsierende Gleichspannung umgewandelt. **
Ähnliche Suchbegriffe für Reinforcement-Learning-Fachbücher-von
-
Einstieg in Deep Reinforcement Learning, Fachbücher von Brandon Brown- Grundlegende Konzepte und Terminologie - Praktischer Einsatz mit PyTorch - Projekte umsetzen Dieses Buch zeigt Ihnen, wie Sie Agenten programmieren, die basierend auf direktem Feedback aus ihrer Umgebung selbstständig lernen und sich dabei verbessern. Sie werden Netzwerke mit dem beliebten PyTorch-Deep-Learning-Framework aufbauen, um bestärkende Lernalgorithmen zu erforschen. Diese reichen von Deep-Q-Networks über Methoden zur Gradientenmethode bis hin zu evolutionären Algorithmen. Im weiteren Verlauf des Buches wenden Sie Ihre Kenntnisse in praktischen Projekten wie der Steuerung simulierter Roboter, der Automatisierung von Börsengeschäften oder dem Aufbau eines Spiel-Bots an. Aus dem Inhalt: - Strukturierungsprobleme als Markov-Entscheidungsprozesse - Beliebte Algorithmen wie Deep Q-Networks, Policy Gradient-Methode und Evolutionäre Algorithmen und die Intuitionen, die sie antreiben - Anwendung von Verstärkungslernalgorithmen auf reale Probleme EXTRA: E-Book inside Systemvoraussetzungen für E-Book inside: Internet-Verbindung und Adobe-Reader oder Ebook-Reader bzw. Adobe Digital Editions.39,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Reinforcement Learning: An Introduction, Fachbücher von Richard S. Sutton, Andrew G. BartoDie erheblich erweiterte und aktualisierte Neuauflage eines weit verbreiteten Textes über Reinforcement Learning, einem der aktivsten Forschungsgebiete der künstlichen Intelligenz. Reinforcement Learning ist ein rechnergestützter Ansatz zum Lernen, bei dem ein Agent versucht, die Gesamtmenge der Belohnung zu maximieren, die er beim Interagieren mit einer komplexen, unsicheren Umgebung erhält. In "Reinforcement Learning" bieten Richard Sutton und Andrew Barto eine klare und einfache Darstellung der zentralen Ideen und Algorithmen des Fachgebiets. Diese zweite Auflage wurde erheblich erweitert und aktualisiert, wobei neue Themen behandelt und andere Themen aktualisiert wurden. Wie die erste Auflage konzentriert sich auch diese zweite Auflage auf die grundlegenden Online-Lernalgorithmen, wobei das mathematische Material in schattierten Kästen hervorgehoben wird. Teil I behandelt so viel wie möglich über Reinforcement Learning, ohne über den tabellarischen Fall hinauszugehen, für den exakte Lösungen gefunden werden können. Viele in diesem Teil vorgestellten Algorithmen sind neu in der zweiten Auflage, darunter UCB, Expected Sarsa und Double Learning. Teil II erweitert diese Ideen auf die Funktionsapproximation, mit neuen Abschnitten zu Themen wie künstlichen neuronalen Netzwerken und der Fourier-Basis, und bietet eine erweiterte Behandlung des Off-Policy-Lernens und der Policy-Gradient-Methoden. Teil III enthält neue Kapitel über die Beziehungen von Reinforcement Learning zur Psychologie und Neurowissenschaft sowie ein aktualisiertes Kapitel über Fallstudien, das AlphaGo und AlphaGo Zero, das Spielen von Atari-Spielen und die Wettstrategie von IBM Watson umfasst. Das letzte Kapitel diskutiert die zukünftigen gesellschaftlichen Auswirkungen des Reinforcement Learning.102,30 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
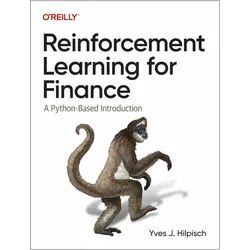
Reinforcement Learning for Finance, Fachbücher von Yves Hilpisch, Hilpisch Yves, Yves J HilpischReinforcement Learning for Finance bietet eine fundierte Einführung in die Anwendung von Reinforcement Learning im Finanzsektor. Verfasst von Yves J. Hilpisch, richtet sich dieses Fachbuch an Leser, die ein Interesse an der Verbindung von Finanzthemen und modernen Techniken der künstlichen Intelligenz haben. Es behandelt die Grundlagen des Reinforcement Learning und zeigt, wie diese Konzepte in der Finanzanalyse und -modellierung eingesetzt werden können. Die praxisorientierte Herangehensweise ermöglicht es den Lesenden, die theoretischen Konzepte durch Python-Programmierung zu vertiefen. Das Buch ist sowohl für Studierende als auch für Fachleute geeignet, die ihre Kenntnisse in der Finanztechnologie erweitern möchten. Mit 212 Seiten bietet es eine umfassende, aber zugängliche Ressource für alle, die sich mit den Herausforderungen und Möglichkeiten des maschinellen Lernens im Finanzbereich auseinandersetzen wollen.56,70 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Transfer Learning for Multiagent Reinforcement Learning Systems, Fachbücher von Anna Helena Reali Costa, Felipe Leno da SilvaDas Buch "Transfer Learning for Multiagent Reinforcement Learning Systems" bietet eine umfassende Analyse der Techniken zur Wissensnutzung in Multiagenten-Systemen innerhalb des Bereichs des Reinforcement Learning (RL). Es beleuchtet die Herausforderungen, die mit der Lösung sequentieller Entscheidungsfindungsaufgaben verbunden sind, und zeigt auf, wie autonome Agenten durch Interaktionen mit ihrer Umgebung trainiert werden. Die Autoren, Anna Helena Reali Costa und Felipe Leno da Silva, diskutieren, wie vorheriges Wissen genutzt werden kann, um den Lernprozess zu beschleunigen und komplexere Aufgaben zu bewältigen. Durch die Einführung einer einheitlichen Taxonomie der aktuellen Lösungen zur Wissensnutzung wird den Lesenden ein klarer Überblick über die Fortschritte in diesem Bereich gegeben. Das Buch richtet sich an Fachleute und Studierende, die sich für die neuesten Entwicklungen in der Technik und IT interessieren und die Mechanismen verstehen möchten, die hinter der Wissenswiederverwendung in Multiagenten-RL-Systemen stehen.64,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist eine Z-Diode mit einer Spannung von 5 Volt?
Eine Z-Diode ist eine spezielle Art von Diode, die für ihre Zener-Spannung bekannt ist. Eine Z-Diode mit einer Spannung von 5 Volt bedeutet, dass sie bei einer bestimmten Spannung in Durchlassrichtung zu leiten beginnt und diese Spannung bei 5 Volt liegt. Sie wird häufig in Schaltungen verwendet, um eine konstante Spannung zu erzeugen oder um Spannungsspitzen zu begrenzen. **
-
Was ist eine Z-Diode mit einer Spannung von 3 Volt?
Eine Z-Diode mit einer Spannung von 3 Volt ist eine spezielle Art von Diode, die als Spannungsregler verwendet wird. Sie hat die Eigenschaft, dass sie bei einer bestimmten Durchbruchspannung in Durchlassrichtung arbeitet und die Spannung auf diesem Wert begrenzt. Dadurch kann sie dazu verwendet werden, eine konstante Spannung von 3 Volt zu erzeugen, unabhängig von Schwankungen in der Eingangsspannung. **
-
Wie lautet die Reihenschaltung von Widerstand und Spule?
Die Reihenschaltung von Widerstand und Spule ergibt eine Impedanz, die den Gesamtwiderstand des Schaltkreises bestimmt. Der Widerstand und die Spule beeinflussen sich gegenseitig, wodurch der Stromfluss und die Spannung über den Bauteilen beeinflusst werden. In einer Reihenschaltung ist der Gesamtwiderstand gleich der Summe des Widerstands und der Spulenimpedanz. **
-
Von was ist der Widerstand einer Spule abhängig?
Der Widerstand einer Spule ist von verschiedenen Faktoren abhängig. Dazu gehören die Länge und der Querschnitt des Drahtes, aus dem die Spule besteht, sowie das Material des Drahtes. Außerdem spielt die Anzahl der Windungen und der Durchmesser der Spule eine Rolle. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.